


**摘要:**4 位行波进位加法器将四个全加器串联,使每一级的输出进位馈入下一级的输入进位。其架构简单但速度慢:总传播延迟按 线性增长,因此高速 CPU 会改用超前进位加法器。
单个全加器之后,自然的下一步便是多位加法。相加 和 这样的两个 4 位数,需要将四个全加器串联,使一列产生的进位能够传播至下一列。
这就是4 位行波进位加法器——大多数学生构建的第一个“复杂”系统:布尔代数的理论之美在此与传播延迟的物理现实相遇。本指南将用串联元件构建它,推导延迟公式,并说明如何检测溢出。
什么是行波进位加法器?
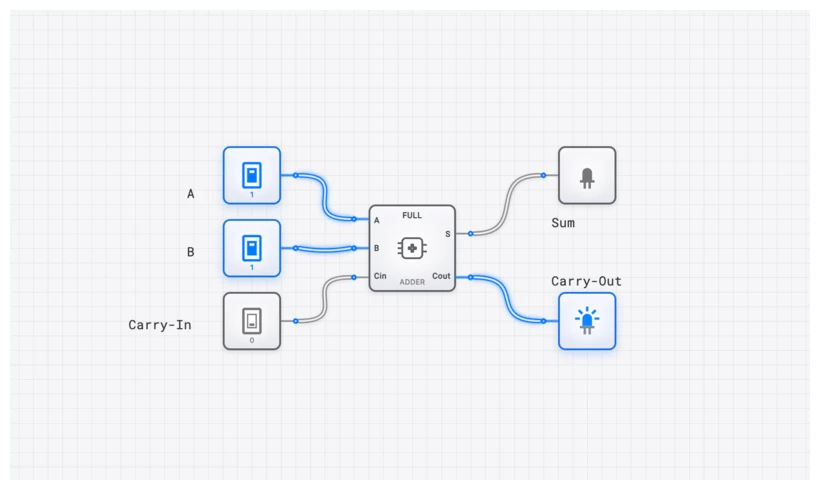
从本质上说,行波进位加法器是一种组合逻辑电路,用于产生两个二进制数的算术和。单个 FULL_ADDER 处理三个输入(两个位加一个输入进位)并产生两个输出(和与输出进位),而 4 位加法器必须处理两个 4 位字。
名称中的“行波”描述的是进位位的行为。在多位加法中,最低有效位(LSB)产生的进位必须传给下一位,下一位可能再为其后一位产生进位,如此继续。进位确实会沿着加法器链从右至左“波纹般”传递。
在 DigiSim.io 中,FULL_ADDER 是构建该层次结构的基本单元。后续高级主题将表明,多数数字算术电路都由此类单元按特定结构组合而成。
链式架构
要构建 4 位加法器,需要四个 FULL_ADDER 元件。将输入标记为 (位 )和 (位 )。
- **第 0 级(LSB):**接收 、 和一个 (通常连接到 CONSTANT_ZERO)。
- **第 1 级:**接收 、 以及第 0 级的 。
- **第 2 级:**接收 、 以及第 1 级的 。
- **第 3 级(MSB):**接收 、 以及第 2 级的 。
最终输出由四个和位()和一个最终输出进位()构成;后者表示无符号 4 位算术中的溢出。
技术规范:真值表
4 位加法器的完整真值表需要 行(512 个条目!),但可通过关键测试用例来验证逻辑。
| A(十进制) | B(十进制) | A(二进制) | B(二进制) | 和(二进制) | 结果(十进制) | |
|---|---|---|---|---|---|---|
| 0 | 0 | 0000 | 0000 | 0000 | 0 | 0 |
| 7 | 1 | 0111 | 0001 | 1000 | 0 | 8 |
| 9 | 6 | 1001 | 0110 | 1111 | 0 | 15 |
| 15 | 1 | 1111 | 0001 | 0000 | 1 | 16(溢出) |
| 15 | 15 | 1111 | 1111 | 1110 | 1 | 30(溢出) |
布尔基础
行波进位加法器的每一级均由两个主要方程支配。对于任意位 :
和方程:
输出进位方程:
在 DigiSim.io 中,查看 FULL_ADDER 的内部逻辑门即可观察这些方程的实现方式。它通常使用两个 XOR 门生成和,并使用 AND/OR 门组合实现进位逻辑。
常见陷阱:传播延迟瓶颈
在模拟器中,信号似乎会瞬时到达;在真实硅片和高保真模拟中并非如此。相关物理原理参见传播延迟。
行波进位加法器出了名地慢。为什么?因为第 3 级必须等待第 2 级提供进位后,才能计算最终和;第 2 级在等第 1 级,第 1 级则在等第 0 级。
若每个 FULL_ADDER 的进位路径传播延迟()为 2 ns,则 4 位加法器需要 8 ns 才能使进位稳定。按相同理想模型估算,64 位行波进位加法器的一次加法需要 128 ns;而 3 GHz 时钟的周期约为 0.33 ns,因此该实现无法满足单周期时序要求。
行波延迟公式:
对于一个 位行波进位加法器,最坏情况下的总传播延迟为:
位宽与延迟之间的这种线性关系,是行波进位架构的根本弱点。这正是发明**超前进位加法器(CLA)**的原因。CLA 使用额外的“生成”()和“传播”()信号,从原始输入同时计算所有进位位;它以更复杂的门逻辑为代价,将延迟从 降至 。
在 DigiSim.io 中调试电路时,若改变输入后输出短暂闪烁,该现象即反映了行波进位链的稳定过程。
在 DigiSim.io 中构建电路
可按以下步骤构建 4 位算术单元:
- **放置输入:**使用两组、每组四个 INPUT_SWITCH 元件。将它们标为 和 。
- **添加逻辑:**将四个 FULL_ADDER 元件放置到画布上。
- **进位链:**将第一个加法器的 连接到第二个的 。对全部四级重复此操作。
- **将第一个进位接地:**将 LSB 加法器的 连接到 CONSTANT_ZERO。
- **可视化输出:**将四个和输出连接到一个 DIGIT_DISPLAY 或四个 OUTPUT_LIGHT 元件。将最终 连接到单独的“溢出”指示灯。
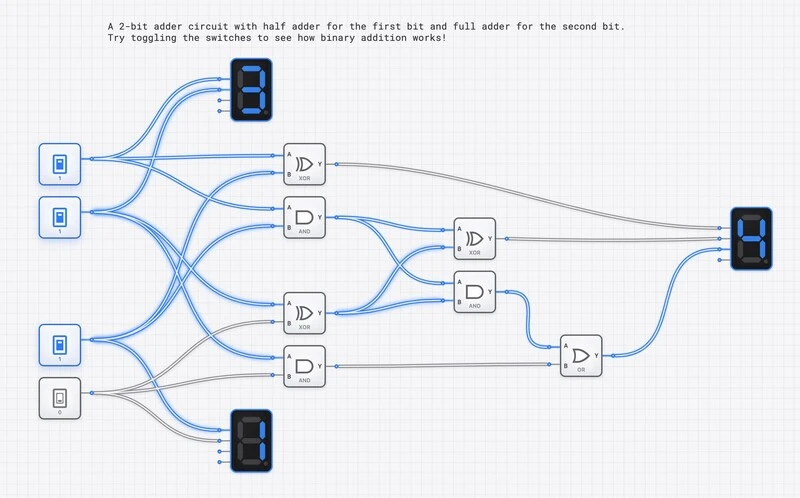
注意:上图展示的是 2 位版本;4 位版本采用相同原理,只需继续串联。
使用 OSCILLOSCOPE_8CH 验证
要观察“行波”效应,将 OSCILLOSCOPE_8CH 连接到电路,并在输入改变时捕获每一级的输出进位。
- 通道 1:(触发信号)
- **通道 2:**第 0 级的
- **通道 3:**第 1 级的
- **通道 4:**第 2 级的
- **通道 5:**第 3 级的
当 全部为 HIGH 时,将 从 LOW 切换为 HIGH,示波器会显示错开的阶梯波形:每个通道均比前一通道稍晚变为 HIGH。这正是行波延迟的物理表现。若时钟频率过高,下一次操作可能在进位尚未传播到末端前开始。
现实应用与 IC
在 20 世纪 70 和 80 年代,工程师不会用单独的门电路搭建这些加法器;他们使用专用集成电路(IC)。其中最著名的是 74LS283。
74LS283 是高速 4 位二进制全加器。有趣的是,其内部并未使用纯粹的行波进位,而是采用称为超前进位逻辑的技术。它不等待进位逐级传递,而是用额外的门基于所有输入同时“预测”是否会产生进位。它因此比刚构建的电路快得多,但逻辑结果完全相同。
此类加法器常见于以下设备的核心数据通路:
- **Intel 8086:**现代 PC 处理器的祖先,其 ALU 中使用了类似的加法器结构。
- **Game Boy:**初代 Game Boy 内部的 Sharp LR35902 处理器依靠 8 位加法电路处理精灵坐标和游戏逻辑。
高级概念:溢出检测
如何得知 4 位加法器是否因为数值过大而“失败”?
对于无符号数,很简单:最终 为 1 时即发生溢出。对于有符号数(二进制补码),则更复杂:当进入 MSB 的进位与离开 MSB 的进位不同时,就会发生有符号溢出。
有符号溢出公式:
在 DigiSim.io 的结构化学习路径中,有符号算术与溢出单元将进一步分析这一主题。正确处理溢出有助于避免“2038 年问题”或电子游戏整数回绕等错误。
总结与下一步
4 位行波进位加法器是理解多位算术与进位传播的基础实例。它说明数字逻辑不仅涉及真值表,还涉及信号随时间的传播。
串联 FULL_ADDER 元件即可由基本逻辑门构成功能完整的算术单元,同时也会引入限制高速计算的关键因素:传播延迟。
实践步骤:
- 打开 DigiSim.io,从零开始构建 4 位加法器。
- 尝试相加 ,观察进位穿过全部四级的行波过程。
- 通过一个BCD 解码器连接 SEVEN_SEGMENT_DISPLAY,以查看十进制结果。
继续学习取指—译码—执行周期,了解这个 ALU 原语如何接入 CPU;或者直接打开FULL_ADDER 元件参考。


