


简述: 在等延迟二输入门模型中,宽 AND/OR/XOR 门可采用级联结构(线性时延,)或平衡树结构(对数时延,)。两者使用相同数量的门,但平衡树缩短了最长信号路径。
基础逻辑门通常处理两个输入,实际系统则需要处理更多输入。存储器地址译码器可能需要对 20 条信号线执行 AND 运算;奇偶校验发生器则必须对整条数据总线执行 XOR 运算。较小逻辑门组合为宽门的拓扑结构,会直接影响电路时延。
本文考察构建多输入门的两种主要策略(级联与树形),推导它们的传播延迟公式,并说明各自适用的情形。
定义及其在数字层级中的角色
多输入逻辑门对三个或更多输入执行 AND、OR 或 XOR 等基本布尔运算,并产生单一输出。在数字系统层级中,它们位于基础双输入原语之上,用于归约复杂条件。
在 32 位 CPU 中,信号以整条总线而非成对形式出现。多输入逻辑将这些宽数据路径压缩为有意义的控制信号——这是译码器与编码器的基础。
- AND: 输入 AND 门当且仅当全部输入均为 1 时输出 1。
- OR: 输入 OR 门在至少一个输入为 1 时输出 1。
- XOR: 输入 XOR 门在值为 1 的输入数量为奇数时输出 1。这是双输入 XOR 定义向多输入情形的奇偶校验扩展。
技术规格:三输入 AND 参考
为理解扩展,先看三输入 AND 门真值表。对于任意 输入门,真值表有 种输入组合。随 增长,表呈指数扩展,但逻辑保持一致。
| 输入 A | 输入 B | 输入 C | 输出 Y |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | 0 |
| 0 | 1 | 0 | 0 |
| 0 | 1 | 1 | 0 |
| 1 | 0 | 0 | 0 |
| 1 | 0 | 1 | 0 |
| 1 | 1 | 0 | 0 |
| 1 | 1 | 1 | 1 |
表中只有最后一行——所有输入均为 HIGH——产生 HIGH 输出。这种“严格性”使 AND 门成为地址译码和使能信号生成的主要工具。
布尔表达式与扩展
这些门的数学表示遵循布尔代数标准定律,特别是结合律。 为由小门构建大门提供理论依据。
对于 输入 AND 门:
对于 输入 OR 门:
对于 输入 XOR 门(奇偶校验):
对于 NAND 与 NOR,可依据德摩根定理分析其多输入行为。 输入 NAND 并非多个 NAND 的简单级联,而是 输入 AND 运算后接一次 NOT 运算。
关键权衡:传播延迟
物理库只提供有限的门扇入集合,可编程逻辑则将布尔函数映射到可用查找表和布线。因此,128 输入 AND 等极宽归约通常分解为较小的单元或 LUT,而非实现成理想的单一符号。
小门的排列方式影响传播延迟(),即输入变化影响输出所需时间。下列方程先假定相同二输入门、延迟为 ,并忽略布线和负载。该模型揭示逻辑深度;物理结果还取决于映射单元延迟、转换时间、扇出、布线、布局与工作角。
实现策略 A:级联(线性逻辑深度)
构建八输入 AND 门最直观的方式是串接:将第一个二输入 AND 输出送入下一个,依此类推。
在这种“级联”结构中,输入 A 的信号必须连续穿过七个门才能到达输出。总延迟呈线性关系:
若 为 1 ns,八输入门的最坏路径时延为 7 ns;在同步系统中,该时延会限制最高时钟频率。
实现策略 B:树形结构(对数逻辑深度)
“树形”或“锦标赛”结构将输入配对:A、B 进入一个门,C、D 进入另一个,E、F 进入第三个,G、H 进入第四个。四个输出再进入下一层两个门,最后进入一个门。
总延迟现按对数增长:
对于八输入门, 。时延为 ,不到级联结构 7 ns 时延的一半。
并列比较
| 指标 | 级联(n=8) | 树形(n=8) |
|---|---|---|
| 延迟公式 | ||
| 总延迟 | ||
| 门数 | ||
| 接线复杂度 | 简单链 | 平衡二叉树 |
在相同二输入门模型下,两种结构均使用 个门,而平衡树将最坏逻辑深度从 降至 。实际实现中,综合可能采用宽门、LUT、因式分解或布局特定结构,因此门数与延迟不必精确遵循理想公式。
交互验证:在 digisim.io 中比较时延
可通过并排搭建两种结构来观察时延差异。
- **设置:**在画布上放置八个 INPUT_SWITCH 元件。
- **级联:**构建由七个 AND 门组成的链。将最终输出接至 OUTPUT_LIGHT。
- **树形:**在下方使用七个 AND 门构建树形结构,将最终输出接至第二个 OUTPUT_LIGHT。
- **测试:**打开全部开关,确认两个指示灯均点亮;随后关闭第一个开关(输入 A)。
若仿真器建模了每门延迟,对于穿过完整级联的转换,示波器应显示树形输出更早稳定。若采用理想零延迟模型,两者在同一模拟瞬间更新;此时应改为计数相依逻辑级数。
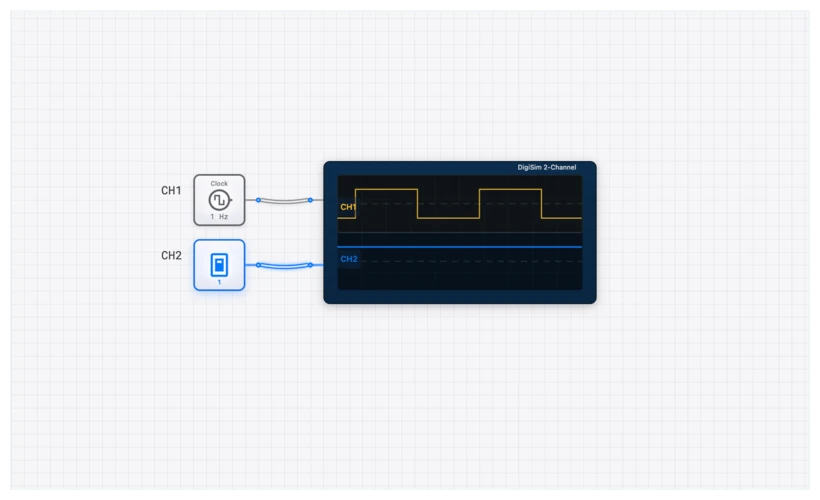
示波器验证
将通道 1 接至被切换输入,通道 2 接至树形输出,通道 3 接至级联输出。在等延迟教学模型中,偏移约为 与 。该实验解释路径深度;生产 FPGA 或 ASIC 的时序收敛使用实现后的网表和布线进行静态时序分析。硬件示波器或逻辑分析仪可诊断某块特定开发板,但无法覆盖每个硅片及环境角。
现实应用
1. 存储器地址译码
内存映射外设通常响应一个地址范围。高位地址比特与基准模式比较,低位比特选择设备内部的寄存器或位置。
在布尔层面,精确匹配是原地址位或补地址位的 AND。物理实现会把该比较分解到可用门、比较器单元或 LUT 中,也可能分层译码。正确的结构是实现后满足总线时序和电气要求的结构,而不是强制手绘二叉树。
2. 数据总线奇偶校验生成
传输一个字节数据时,常加入奇偶校验位以检测错误。采用偶校验时,若数据中 1 的数量为奇数,则校验位置 1,使码字中 1 的总数成为偶数。
这正是多输入 XOR 门所做的事。
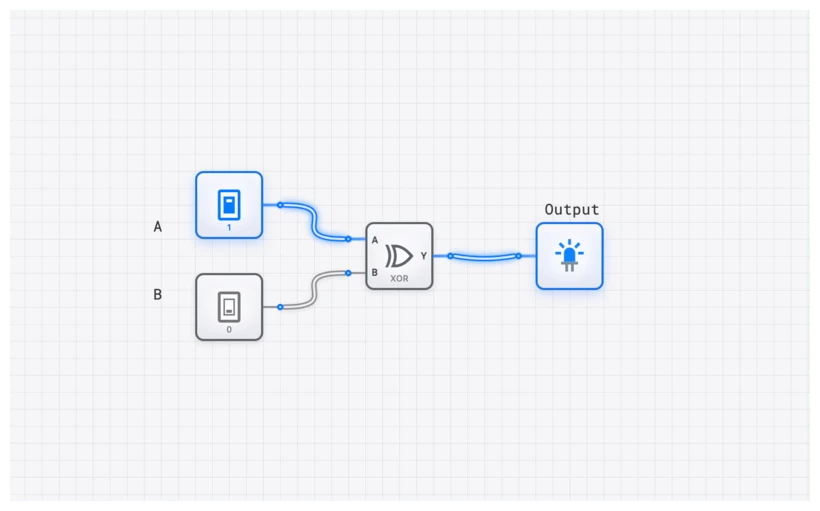
64 输入的二输入 XOR 门平衡树有六个逻辑级,因为 。奇偶校验及更丰富的纠错码用于多种存储和通信路径,但具体代码、覆盖范围和更新点依架构而定。参见错误检测中的 XOR 与 XNOR。
课程中的相关主题
以下主题可进一步补充相关知识:
- 基础逻辑门(原语)
- 布尔代数与德摩根(数学)
- 传播延迟与时序图(性能)
- 译码器(多输入 AND 的主要应用)
总结:设计准则
| 准则 | 细节 |
|---|---|
| 减少相依深度 | 仅有二输入门时,平衡归约是合理的起点,再由综合工具映射到目标资源。 |
| 尊重库扇入 | 可用且高效的扇入取决于逻辑系列、标准单元库或 FPGA LUT 架构。 |
| 考虑扇出 | 每个门输出驱动许多输入都会引入额外延迟。为高扇出节点加缓冲。 |
| 包含布线和负载 | 相同门数并不意味着实现后的面积、功耗、布局或延迟相同。 |
| 使用正确的验证 | 使用 DigiSim 比较逻辑深度和建模延迟;使用目标实现工具验证物理时序。 |
从双输入门扩展到多输入系统后,设计不仅要保证逻辑正确,还必须满足时序与实现约束。


