


**要約:**伝搬遅延()は、指定された入力しきい値交差から対応する出力しきい値交差までの時間間隔です。これはデバイス、負荷、入力スルー、電圧、温度、プロセス、配線に依存します。同期論理では、データパスの最大遅延がセットアップ・タイミングに、最小遅延がホールド・タイミングに寄与します。どちらも検証が必要です。
実際のゲートと配線は瞬時には応答しません。その遅延は、短いオンチップ・パスではピコ秒単位、基板レベルのデバイスや重い負荷を持つネットワークではナノ秒以上に及びます。重要なのは設計全体のゲート数ではなく、起点から捕捉点までの各パスに沿った遅延です。
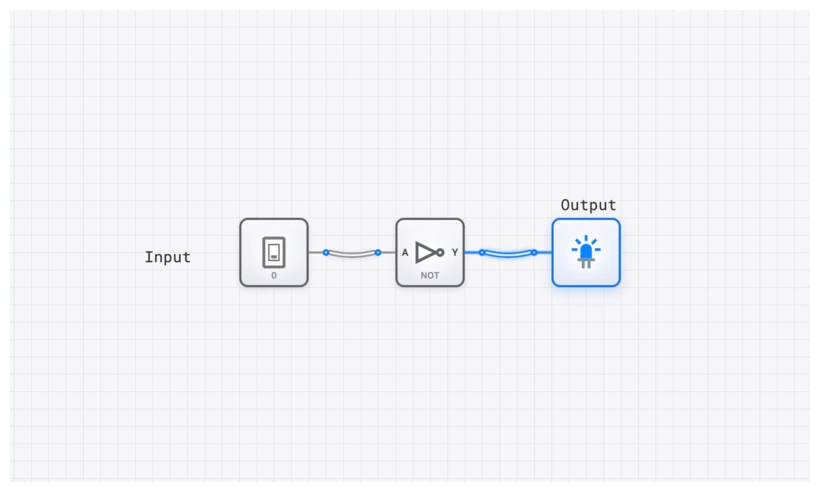
遅延の構造
伝搬遅延は、定義された電圧しきい値間で測定されます。一般には、入力遷移の中点と対応する出力遷移の中点の間です。正確な試験電圧、負荷、電源、入力波形は、デバイスのデータシートで定められます。
この遅延は単一の均一な値ではありません。トランジスタを「オン」に切り替える物理と「オフ」に切り替える物理は異なるため、二つの別個の方法で測定します。
- (LOW から HIGH への遅延):出力が論理 0(LOW)から論理 1(HIGH)へ遷移するのにかかる時間。
- (HIGH から LOW への遅延):出力が論理 1(HIGH)から論理 0(LOW)へ遷移するのにかかる時間。
プルアップ・ネットワークとプルダウン・ネットワークの強度は同一とは限らないため、 と は異なることがあります。どちらが大きいかはトランジスタのサイズと出力負荷で決まり、論理機能だけから一方向を仮定してはいけません。特性評価では、平均値が役に立つこともあります。
最悪ケースのデジタル・タイミングでは、通常この平均ではなく、該当する最大または最小のアークを用います。立上りと立下りの遅延が異なると、クロック・ネットワークのデューティ比歪みにも寄与します。
技術仕様:NOT ゲート
遅延を理解するには、まず最も単純な論理要素である NOT ゲートを理解しなければなりません。その論理は単純ですが、その物理的挙動はすべてのタイミング解析の基礎です。
| 入力遷移 | 出力遷移 | 遅延記号 |
|---|---|---|
| 1 → 0 | 0 → 1 | |
| 0 → 1 | 1 → 0 |
この動作のブール式は次のとおりです。
論理シミュレータは理想的なゼロ遅延ゲート、またはコンポーネントごとに単純化した遅延を用いる場合があります。これはイベント順序やハザードを学ぶには有用ですが、実デバイスのタイミング・モデル、データシート上の制限、静的タイミング解析の代わりにはなりません。
物理的起源:瞬時の応答が不可能な理由
伝搬遅延は、有限の抵抗を通じた容量の充放電と、配線を通る信号伝搬から生じます。複数の変数が同時に寄与します。
1. トランジスタと内部ノードの遅延
論理ゲートには、寄生容量を伴うトランジスタ・ネットワークがあります。状態を変えるには、有限のトランジスタ抵抗を通じて内部ノードと出力ノードを充放電する必要があります。デバイス形状、入力スルー、電源電圧、温度、製造ばらつきはすべて結果に影響します。
2. 配線抵抗、容量、飛行時間
金属配線には抵抗があり、近接導体に対する容量もあります。短いオンチップ配線は分布 RC ネットワークとしてモデル化されることが多く、長い PCB 配線は有限の伝搬速度を持つ伝送線路として振る舞います。結合、形状、終端、受信側しきい値が、宛先がエッジを認識する時点に影響します。
3. 負荷容量とファンアウト
駆動される各入力、パッケージ・ピン、プローブ、配線長が負荷に寄与します。容量が大きいほど一般に出力エッジは遅くなり、次のしきい値で測定される伝搬遅延も変化します。データシートの遅延制限は、記載された試験条件下でのみ有効です。そのため、15 pF または 50 pF で示された数値を、別の負荷へ無条件に転用してはいけません。
クリティカルパス:回路の究極の速度制限
多段の論理パスでは、セルと配線の遅延が累積します。並列分岐の遅延がすべて加算されるわけではありません。タイミングは、各起点から各捕捉点までの可能なパスごとに追跡します。
ここから クリティカルパス が導かれます。すなわち、特定の制約および動作条件においてセットアップ・スラックが最も小さいパスです。単純な単一クロック設計では、多くの場合、最大遅延が最長のレジスタ間パスです。実際のタイミング・ツールは、入力/出力パス、生成クロック、クロックスキュー、例外も解析します。
digisim.io の ADDER コンポーネントを使って作れる、古典的な4 ビット・リップルキャリー加算器を考えてみましょう。これは四つの全加算器回路を連結して構成されます。最初の段の和ビット()はすぐに計算されます。しかし、最初の段のキャリー出力ビット()は、二番目の段の和()を計算するために必要です。この依存関係は後段まで続きます。最後の和ビット は、キャリー信号が先行する三つの段を「リップル」して通過するまで計算できません。
各全加算器のキャリー段が同程度の遅延 を持つなら、4 ビットのリップル設計における最終キャリーには、おおよそ に配線と負荷の影響を加えた時間がかかります。同じトポロジーを 64 ビットに拡張すると、キャリー・パスはおよそ線形に増大します。これがキャリー先読み構造や並列プレフィックス構造の動機です。
理想的なクロック到達を仮定した単純化された同一クロック・パスでは、クロック周期は、ソース・レジスタがデータを出力し、最大遅延パスが安定し、宛先レジスタのセットアップ時間を満たすだけの余裕を持たなければなりません。
ここで:
- は、クロック・エッジ後にレジスタの出力が変化するまでの時間です。
- は、レジスタ間で最も長い論理パスの遅延です。
- は、次のクロック・エッジの前にデータがレジスタ入力で安定していなければならない時間です。
この単純化したモデルで対応する上限は、次のとおりです。
実運用の静的タイミング解析では、クロック到達時刻と不確実性も含め、多数のプロセス、電圧、温度コーナーを評価します。別途行う最小遅延チェックでホールド時間を検証します。パスはセットアップを満たしても、ホールドに失敗する可能性があります。
よくある落とし穴:グリッチ、ハザード、レース条件
関連する信号が不等な遅延を持つパスを通り、後で再収束すると、出力が意図しない値を短時間取ることがあります。これは 組合せハザード です。「レース」という語はより広く、非同期回路や順序回路における状態依存の挙動にも使われるため、この二つの語は厳密な同義語ではありません。
よくある例は です。数学的には常に 0 です。実際のゲートで構成すると、 は AND ゲートへ直接入力される一方、NOT ゲートにも入力され、その出力が同じ AND ゲートへ入ります。
が 0 から 1 へ遷移すると、AND ゲートへの直接パスでは新しい 1 がほぼ瞬時に到達します。しかし、もう一方のパスはまず NOT ゲートを通過する必要があり、伝搬遅延 が導入されます。短い瞬間、すなわち に等しい間、AND ゲートの両入力は 1 になります(直接パス上の新しい の値と、インバータをまだ伝搬中の の古い値です)。その結果、出力 はグリッチし、0 のままであるべきところで瞬間的に 1 へパルスします。(教科書ではこれを static-0 hazard と呼びます。出力は LOW のままであるべきなのに、短時間 HIGH になります。)
過渡現象は、下流レジスタのサンプリング・ウィンドウより前に収束すれば無害な場合がありますが、非同期制御、クロック、その他のパルス感度を持つ入力へ到達すれば有害になり得ます。波形ビューアがそのイベントを示せるのは、シミュレータがそれを生む不均等なパス遅延をモデル化している場合だけです。
リングオシレータによる遅延の可視化
累積遅延を示すコンパクトな実演の一つが リングオシレータ です。ただし、物理ゲート、またはゼロではない伝搬遅延を持つフィードバックをサポートするシミュレータが必要です。
リングオシレータは、ループ状に接続された奇数個の反転段からなります。物理ハードウェアでは、全段が整合的に安定することはできず、有限の遅延によって発振が生じます。周波数は、ゲート数だけでなく、段の遅延、負荷、電源、温度、プロセスに依存します。
段階的な構築
- モデルを確認する:シミュレータが組合せフィードバックとゼロではないゲート遅延をサポートすることを確認します。理想的なゼロ遅延論理を使う場合は、物理デバイスまたは遅延を認識する HDL シミュレータでこの実験を行ってください。
- ゲートを配置する:NOT ゲートを三つ一列に配置します。
- 連結する:一つ目の出力を二つ目の入力へ、二つ目の出力を三つ目の入力へ接続します。
- ループを閉じる:三つ目の NOT ゲートの出力を一つ目の入力へ戻して接続します。
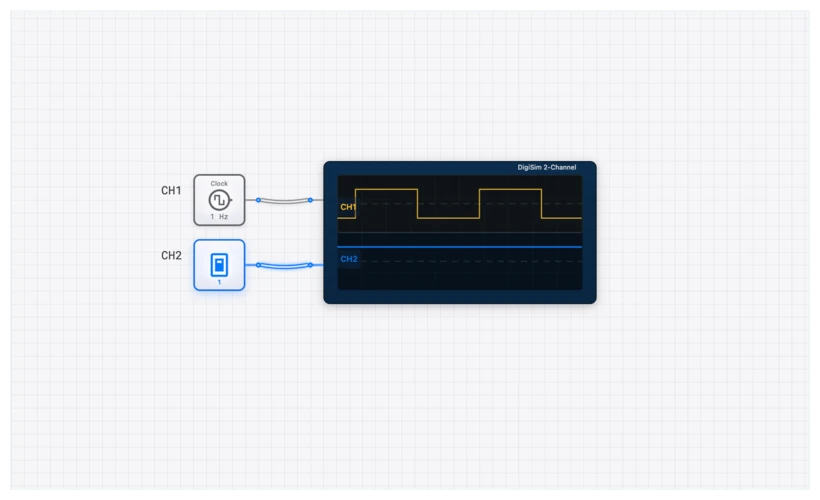
- 計測手段を加える:波形チャネルを三つ目のゲートの出力へ接続します。
構築したのは、出力が絶えず自分自身を追いかける回路です。信号は反転し、インバータの連鎖を伝搬し、反転された状態で始点に戻るため、再び反転します。一回の完全な発振に要する時間は、累積した伝搬遅延に直接関係します。
個の同様の段では、一次近似は次のとおりです。
ここで、 はインバータの数、 は単一インバータの平均伝搬遅延です。係数 2 が現れるのは、完全な発振には信号が連鎖を二回通過する必要があるためです。一回は HIGH への遷移、もう一回は LOW への遷移です。したがって発振周波数は次のとおりです。
他の条件が同程度であれば、二段を追加すると周波数は低下するはずです。式を変形すると、配線と負荷を含む 有効平均段遅延 を見積もれます。オンチップ・リングオシレータはプロセス、電圧、温度のモニタに使われますが、精密なセル特性評価では、この一つの推定だけでなく、制御されたテスト構造、波形、統計モデルを使用します。
実世界での利用:遅延を制御する
伝搬遅延の管理は、ハードウェア・エンジニアの日常的な課題です。単に高速化するだけではなく、そもそも動作させるための取り組みです。
CPU コア設計
プロセッサの実現可能な動作点は、設計全体でのタイミング・クロージャに加え、電圧、温度、電力、製品マージンに依存します。エンジニアは静的タイミング解析を使って負または小さいスラックのパスを見つけ、論理構造、パイプライン境界、配置、配線、バッファリング、セル・サイズを変更することがあります。すべてのモードと動作コーナーにわたって、恒久的に一つだけ「クリティカル」なパスが存在することはほとんどありません。
高速データ・インターフェース
DDR のような並列インターフェースは、データ、ストローブ、クロック、コマンド、パッケージ、ビア間の到達関係を管理します。PCB 設計者はタイミング予算と信号品質予算を満たすように信号を配線し、必要に応じて蛇行配線の長さを加えます。目標は同じ幾何学的長さではなく、制御された 電気的遅延 です。パッケージ遅延、層内の伝搬速度、結合、コントローラのトレーニングはいずれも予算に影響し得ます。
論理のリズムを身につける
伝搬遅延は、ブール設計と物理的実装を結び付けます。なぜパス深さが重要なのか、正しい真理値表でも遷移中にグリッチし得る理由、最大遅延と最小遅延の両方のチェックが必要な理由を説明します。
タイミングを調べる間は波形ビューアを開いておきましょう。表示される遅れはシミュレータの遅延モデルの挙動です。ハードウェアについて結論を出す前に、コンポーネントのデータシートまたは実装のタイミング・レポートと比較してください。
伝搬遅延を囲む制約についてはセットアップ、ホールド、メタスタビリティへ、カスケードとツリーの深さについては多入力論理ゲートへ進んでください。NOT ゲートのコンポーネント参照には、リングオシレータの演習で使う論理動作が載っています。
エンジニアリング参考資料
- Texas Instruments、Designing With Logic — 伝搬遅延、出力負荷、データシートの試験条件。
- AMD、Reviewing Timing Slack — セットアップ/ホールド・スラック、スキュー、不確実性、パス解析。


