
二進数加算を極める:4 ビット行波桁上がり加算器を作る
4 ビット行波桁上がり加算器は、四つの全加算器を連結して多ビットの数を加算します。アーキテクチャ、伝搬遅延、オーバーフロー検出、構築方法を扱います。


**要約:**4 ビット行波桁上がり加算器は、四つの全加算器を連結し、各段の出力桁上がりを次段の入力桁上がりへ渡します。アーキテクチャは単純ですが低速で、総伝搬遅延は として線形に増加します。そのため高速 CPU では、代わりに桁上がり先読み加算器が使われます。
単一の全加算器の次に自然に進むのは、多ビット加算です。 と のような二つの 4 ビット数を加算するには、ある桁で生成された桁上がりを次の桁へ伝搬できるよう、四つの全加算器を連結する必要があります。
これが 4 ビット行波桁上がり加算器です。多くの学習者が最初に作る「複雑な」システムであり、ブール代数の理論的な美しさが伝搬遅延という物理的な現実と出会う場所です。このガイドでは、連結したコンポーネントから回路を構築し、遅延式を導出し、オーバーフローの検出方法を示します。
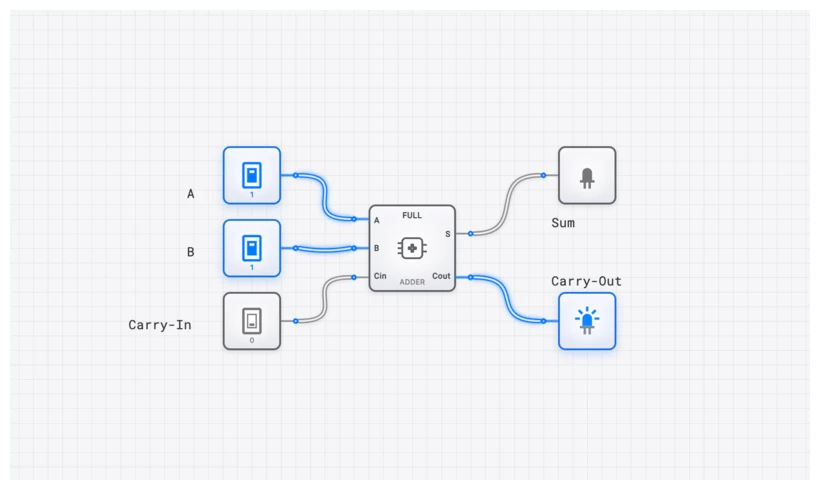
行波桁上がり加算器とは?
行波桁上がり加算器は、二つの二進数の算術和を生成する組合せ論理回路です。単一の FULL_ADDER は三つの入力(二つのビットと入力桁上がり)を処理して二つの出力(和と出力桁上がり)を生成しますが、4 ビット加算器は二つの 4 ビットワードを処理しなければなりません。
名称にある「行波」は、桁上がりビットの動きを表しています。多ビット加算では、最下位ビット(LSB)で生成された桁上がりを次のビットへ渡す必要があり、そのビットがさらに次のビットの桁上がりを生成することがあります。桁上がりは、加算器の連鎖を右から左へ文字どおり「波及」していきます。
digisim.io のエコシステムでは、この階層の基本構成要素を FULL_ADDER として扱います。カリキュラムの高度なトピックへ進むころには、ほとんどすべてのデジタル算術が、これらのブロックを巧みに組み合わせたものだと分かるでしょう。
連鎖のアーキテクチャ
4 ビット加算器を作るには、四つの FULL_ADDER コンポーネントが必要です。入力を (ビット )と (ビット )と表します。
- ステージ 0(LSB):、、(通常は CONSTANT_ZERO に接続)を受け取ります。
- ステージ 1:、、ステージ 0 からの を受け取ります。
- ステージ 2:、、ステージ 1 からの を受け取ります。
- ステージ 3(MSB):、、ステージ 2 からの を受け取ります。
最終出力は四つの和ビット()と、一つの最終出力桁上がり()で構成されます。後者は、符号なし 4 ビット算術でのオーバーフローを表します。
技術仕様:真理値表
4 ビット加算器の完全な真理値表には 行(512 エントリ)が必要ですが、重要なテストケースを見れば論理を検証できます。
| A(10 進数) | B(10 進数) | A(二進数) | B(二進数) | 和(二進数) | 結果(10 進数) | |
|---|---|---|---|---|---|---|
| 0 | 0 | 0000 | 0000 | 0000 | 0 | 0 |
| 7 | 1 | 0111 | 0001 | 1000 | 0 | 8 |
| 9 | 6 | 1001 | 0110 | 1111 | 0 | 15 |
| 15 | 1 | 1111 | 0001 | 0000 | 1 | 16(オーバーフロー) |
| 15 | 15 | 1111 | 1111 | 1110 | 1 | 30(オーバーフロー) |
ブール論理の基礎
行波桁上がり加算器の各ステージは、二つの基本式に支配されます。任意のビット について、次のようになります。
和の式:
出力桁上がりの式:
digisim.io では、FULL_ADDER の内部ゲートを見ると、これらの式がどう働くかを確認できます。通常、和には二つの XOR ゲート、桁上がり論理には AND/OR ゲートの組み合わせが使われます。
よくある落とし穴:伝搬遅延のボトルネック
シミュレータでは、信号が瞬時に変化するように感じられます。しかし、実際のシリコンや高忠実度のシミュレーションではそうではありません。その背後にある物理については、伝搬遅延を参照してください。
行波桁上がり加算器が遅いことで知られるのはなぜでしょうか。ステージ 3 は、ステージ 2 が桁上がりを出力するまで最終的な和を計算できません。ステージ 2 はステージ 1 を待ち、ステージ 1 はステージ 0 を待っています。
各 FULL_ADDER の桁上がり経路に 2 ナノ秒の伝搬遅延()がある場合、4 ビット加算器では桁上がりが安定するまでに 8ns かかります。大した時間には聞こえないかもしれませんが、現代の CPU で 64 ビット行波桁上がり加算器を考えてみてください。一回の加算だけで 128ns かかることになります。3GHz のクロック速度では、CPU サイクルはわずか 0.33ns です。この計算は成り立ちません。
行波遅延の式:
ビット行波桁上がり加算器の最悪ケースにおける総伝搬遅延は、次のとおりです。
ビット幅と遅延のこの線形関係が、行波桁上がりアーキテクチャの根本的な弱点です。まさにこのために 桁上がり先読み加算器(CLA) が発明されました。CLA は、追加の「生成」信号()と「伝搬」信号()を使って、元の入力からすべての桁上がりビットを同時に計算します。より複雑なゲート論理を代償に、遅延を から へ減らします。
digisim.io で回路をデバッグしているときに、入力を変えた直後に出力が短くちらつくなら、それは行波桁上がりの安定時間を見ているのです。
digisim.io で回路を組み立てる
実際に手を動かしてみましょう。次の手順で、自分の 4 ビット算術ユニットを構築します。
- **入力を配置する:**それぞれ四つの INPUT_SWITCH コンポーネントからなる二組を使います。 と とラベル付けします。
- **論理を追加する:**四つの FULL_ADDER コンポーネントをキャンバスに配置します。
- **桁上がり連鎖を作る:**最初の加算器の を、二つ目の へ接続します。これを四つのステージすべてで繰り返します。
- **最初の桁上がりを接地する:**LSB 加算器の を CONSTANT_ZERO へ接続します。
- **出力を可視化する:**四つの Sum 出力を DIGIT_DISPLAY、または四つの OUTPUT_LIGHT コンポーネントへ接続します。最後の は、独立した「オーバーフロー」ライトへ接続します。
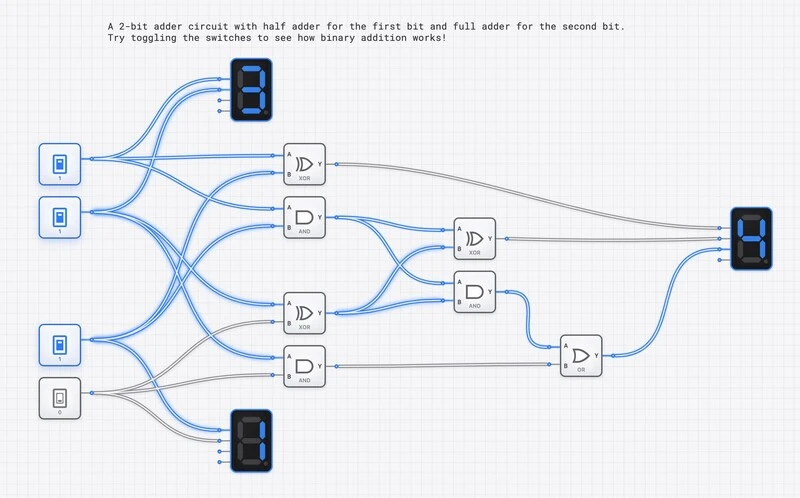
注:上の画像は 2 ビット版ですが、4 ビット版の原理はまったく同じです。連結を続けるだけです。
OSCILLOSCOPE_8CH で検証する
「波及」効果を見るには、OSCILLOSCOPE_8CH を回路へ接続し、入力を変化させながら各ステージの出力桁上がりを記録します。
- チャンネル 1:(トリガ)
- **チャンネル 2:**ステージ 0 の
- **チャンネル 3:**ステージ 1 の
- **チャンネル 4:**ステージ 2 の
- **チャンネル 5:**ステージ 3 の
を LOW から HIGH へ切り替えるとき、 がすべて HIGH なら、オシロスコープ上で段差状のずれた効果が見えます。各チャンネルは、その前のチャンネルより少し遅れて HIGH になります。これが行波遅延の物理的な現れです。クロック速度が高すぎると、桁上がりが最後まで波及し終える前に次の演算が始まってしまうかもしれません。
実世界での応用と IC
1970 年代から 1980 年代にかけて、技術者はこれらを個別のゲートから組み立ててはいませんでした。専用の集積回路(IC)を使っていたのです。最も有名なものが 74LS283 です。
74LS283 は高速 4 ビット二進数全加算器です。興味深いことに、その内部では純粋な行波桁上がりは使われていません。代わりに 桁上がり先読み 論理と呼ばれる技術を使います。桁上がりが波及するのを待つのではなく、追加のゲートによって、すべての入力から桁上がりが生成されるかを同時に「予測」します。このため、先ほど作った回路より大幅に高速ですが、論理結果はまったく同じです。
これらの加算器は、次のようなシステムの中心部にあります。
- **Intel 8086:**現代の PC プロセッサの祖先は、その ALU で類似した加算器構造を使っていました。
- **Game Boy:**初代 Game Boy に搭載された Sharp LR35902 プロセッサは、スプライトの座標やゲームロジックを扱うために 8 ビット加算回路に依存していました。
高度な概念:オーバーフロー検出
数が大きすぎるために、4 ビット加算器が「失敗」したことをどう知ればよいでしょうか。
符号なし数では簡単です。最終 が 1 なら、オーバーフローが起きています。符号付き数(二の補数)では、より複雑です。MSB への入力桁上がりが MSB からの出力桁上がりと異なるとき、符号付きオーバーフローが発生します。
符号付きオーバーフローの式:
digisim.io の体系的な学習パスを進んでいるなら、符号付き算術とオーバーフローでこの概念を詳しく扱います。著名な「2038 年問題」やビデオゲームにおける整数のラップアラウンドのようなバグを防ぐうえで、重要な概念です。
まとめと次のステップ
4 ビット行波桁上がり加算器は、すべてのデジタル設計者にとっての通過儀礼です。論理は真理値表だけでなく、時間を通じてデータが流れることにも関わるのだと教えてくれます。
FULL_ADDER コンポーネントを連結することで、単純なゲートから機能する算術ユニットへ進みました。そして、高速コンピューティングにおける最大の敵、伝搬遅延にも出会いました。
実際に試す準備はできましたか?
- digisim.io を開き、4 ビット加算器をゼロから構築します。
- を加算して、桁上がりが四つのステージすべてを波及する様子を観察します。
- BCD デコーダを介して SEVEN_SEGMENT_DISPLAY を接続し、10 進数の結果を確認します。
フェッチ・デコード・実行サイクルに進み、この ALU の基本要素が CPU にどう組み込まれるかを確認するか、FULL_ADDER コンポーネントリファレンスを直接開いてください。


